Tokens zijn de basiseenheden van data voor LLM's, zoals woorden de basis van zinnen zijn. Een token kan echter van vorm verschillen: het kan deel van een woord zijn, een heel woord, of zelfs leestekens. LLM's functioneren als next-token predictors, die de kans op de volgende token berekenen op basis van de reeks voorgaande tokens.
Neem token zelf als voorbeeld. "Tokens" is 1 token, maar "tokenize" kunnen er 2 zijn.
- Deze zin is 7 tokens.
- We moeten de tekst tokenizen voor betere analyse.
De vraag of "tokenize" een of twee tokens is, hangt af van de frequentie van het woord in de trainingsset van het Large Language Model. In modellen die zijn getraind op uitgebreide woordenschatten, waar er minder noodzaak is om bekende woorden op te splitsen in kleinere eenheden, zou "tokenize" doorgaans als een enkele token worden weergegeven. Is de woordenschat kleiner of het woord minder gangbaar, dan wordt het opgesplitst in twee tokens.
Verschillen in tokengebruik tussen talen
De prestaties van Large Language Models variëren tussen verschillende talen. We gaan hier niet diep op in, maar het aantal tokens dat nodig is voor een gemiddelde zin verschilt flink per taal.
Engels, met zijn duizenden woorden die doorgaans als enkele tokens worden weergegeven, is vaak zuiniger in tokengebruik. Deze efficiëntie komt deels door de codeerstructuur van de LLM, die de neiging heeft Engels te bevoordelen vanwege de dominante aanwezigheid ervan in de trainingsdatasets. Daardoor is Engels een kostenefficiënte taal voor LLM-operaties.
Neem bijvoorbeeld het woord "probability", een relatief lang woord in het Engels en toch telt het als slechts een token. Wanneer het naar andere talen wordt vertaald, is het aantal tokens anders:
- NL - Kans - 2 tokens
- DE - Wahrscheinlichkeit - 4 tokens
- FR - Probabilité - 2 tokens
- ES - Probabilidad - 2 tokens
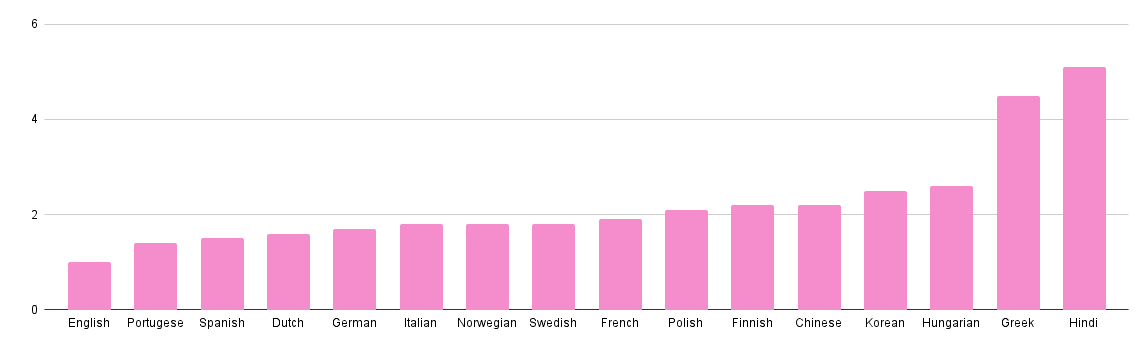
Een exacte vergelijking maken is lastig, maar als het gaat om tokengebruik, zijn grote Europese talen zoals Duits, Frans, Spaans en Nederlands (geen grote taal, dat weten we) ongeveer 1,5 tot 1,7 keer token-intensiever dan Engels. Kleinere Europese talen kunnen nog veeleisender zijn, met Hongaars dat ongeveer 2,5 keer kost en Grieks dat ongeveer 4 keer het tokengebruik van Engels bereikt.
Voor een grote taal als Hindi is de tokenuitgave ongeveer 5 keer die van Engels. Die hogere kosten komen door de complexiteit van de taal, de schriftregels en het gebruik van conjuncte karakters.
Waarom is dit belangrijk?
Als tokengebruik gelijkstaat aan kosten, zijn talen die meer tokens nodig hebben om hetzelfde te zeggen dus een stuk duurder.
Daarnaast is het concept van het context window hier nauw mee verbonden. Het context window is de hoeveelheid tekst (gemeten in tokens) die een model in een keer kan verwerken bij het genereren van een antwoord of het begrijpen van een tekst. Werken in een taal als Hindi verhoogt dus de kosten en beperkt ook de hoeveelheid context die je in een antwoord kunt meenemen. Over context windows schrijven we binnenkort een aparte post.
Terwijl grote spelers als OpenAI en Anthropic per token rekenen, heeft Google's PaLM2-model het rekenen per karakter geïntroduceerd, wat onder bepaalde omstandigheden de kosten zou kunnen verlagen. Een ander alternatief is het deployen van een open-source model, doorgaans gefactureerd per uur gebruik. Deze optie brengt echter vaak hogere setup- en vaste maandelijkse kosten met zich mee, waardoor het meer een optimalisatie is dan een launch-strategie. Bovendien voldoet de kwaliteit van open-source modellen mogelijk niet aan de eisen voor bepaalde use-cases.
Wil je weten welke optie bij jouw situatie past, kijk dan eens naar onze design sprints. We bekijken je content en helpen je de beste aanpak te kiezen.