Afgelopen oktober gingen we met Mozaik naar Italie voor onze allereerste hackathon. Een perfecte plek om even afstand te nemen van de dagelijkse gang van zaken en te werken aan een kleine wensenlijst met problemen waar op een normale werkdag nooit tijd voor is. Een van die problemen was code review, een onderwerp dat momenteel continu in beweging is.
Het probleem
Nu de meeste code met LLM's en coding agents wordt geschreven, wordt code review steeds lastiger. Pull requests worden groter, de scope van features groeit tijdens het bouwen, en de output van een LLM is, zonder configuratie, erg verbose. De kwaliteit van gegenereerde code gaat snel vooruit, dus correctheid is niet langer het grootste probleem bij het schrijven van code. De echte vraag is of de engineer de agent goed genoeg heeft geïnstrueerd, zodat wat er is gebouwd ook echt de feature is die hij of zij in gedachten had.
Voor een reviewer is die vraag nog lastiger. Die kent de context van de feature of bug misschien niet, of erger, kent de codebase helemaal niet. Daarnaast zagen we dat reviewers, als hen om een review werd gevraagd, vaak gewoon een groep agents op de wijzigingen afstuurden. Het resultaat was een approve of een requested changes zonder dat de reviewer de volledige context ooit had begrepen.
We hebben het probleem in tweeën geknipt: de reviewer helpen begrijpen wat een PR hoort te doen, en het deel van de review automatiseren dat toch al door een LLM werd gedaan. Beide draaien als GitHub Actions op elke pull request.
Stap een: beschrijvingen met diagrammen
Om de reviewer een voorsprong te geven, beginnen we bij de beschrijving van de PR. Op basis van de codewijzigingen, de commitberichten, de bestaande PR-beschrijving (meestal geschreven door een agent) en het gekoppelde ticket of epic als dat er is, schrijft de eerste action een korte samenvatting van de wijzigingen. Onderdeel daarvan is een overzicht van wijzigingen in het datamodel en in rollen of rechten. Daar bovenop komen twee sets Mermaid-diagrammen. De eerste laat de wijzigingen in de code flow zien: het veranderde gedrag van de applicatie. De tweede laat zien hoe de vertakkingen van de gewijzigde functies verschillen. Beide tonen oud en nieuw in een plaatje, waardoor de wijziging zichtbaar wordt zonder de diff te lezen.
Beide diagrammen gebruiken dezelfde kleuren: groen voor toegevoegd, rood en gestippeld voor verwijderd, oranje voor gewijzigd en grijs voor ongewijzigde context. Neem een PR die grote bestandsuploads naar een achtergrondtaak stuurt in plaats van ze direct te verwerken. Het code flow-diagram beschrijft het gedrag in producttermen, inclusief de waarden die het bepalen en wat de code aanneemt zonder het te controleren:
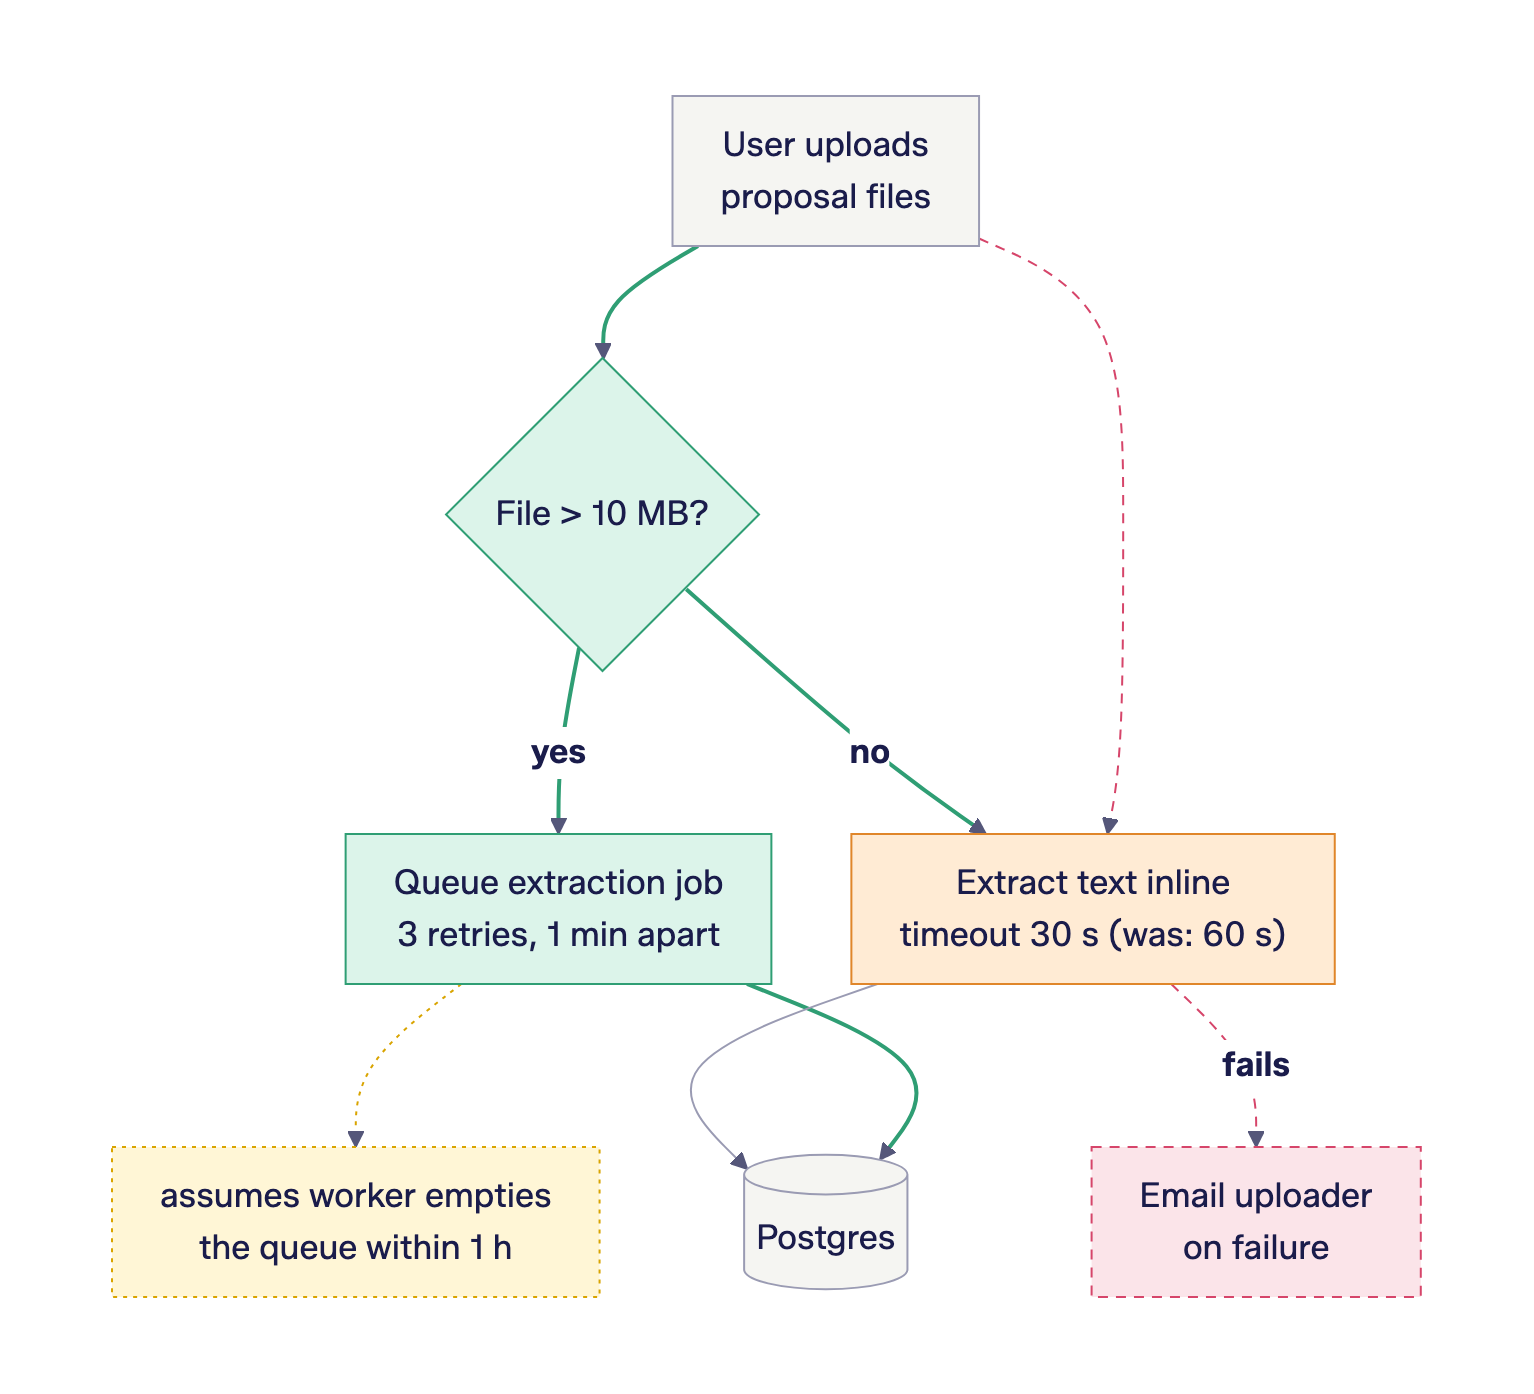
Alleen al uit dit diagram kan een reviewer de vragen stellen die ertoe doen: is 10 MB de juiste grens, is het acceptabel dat de e-mail bij een fout verdwijnt, en leegt de worker de wachtrij echt binnen een uur? Voor geen van deze vragen hoef je eerst de diff te lezen.
Het code path-diagram laat dezelfde wijziging zien op het niveau van een enkele functie, met de namen zoals ze in de code staan:
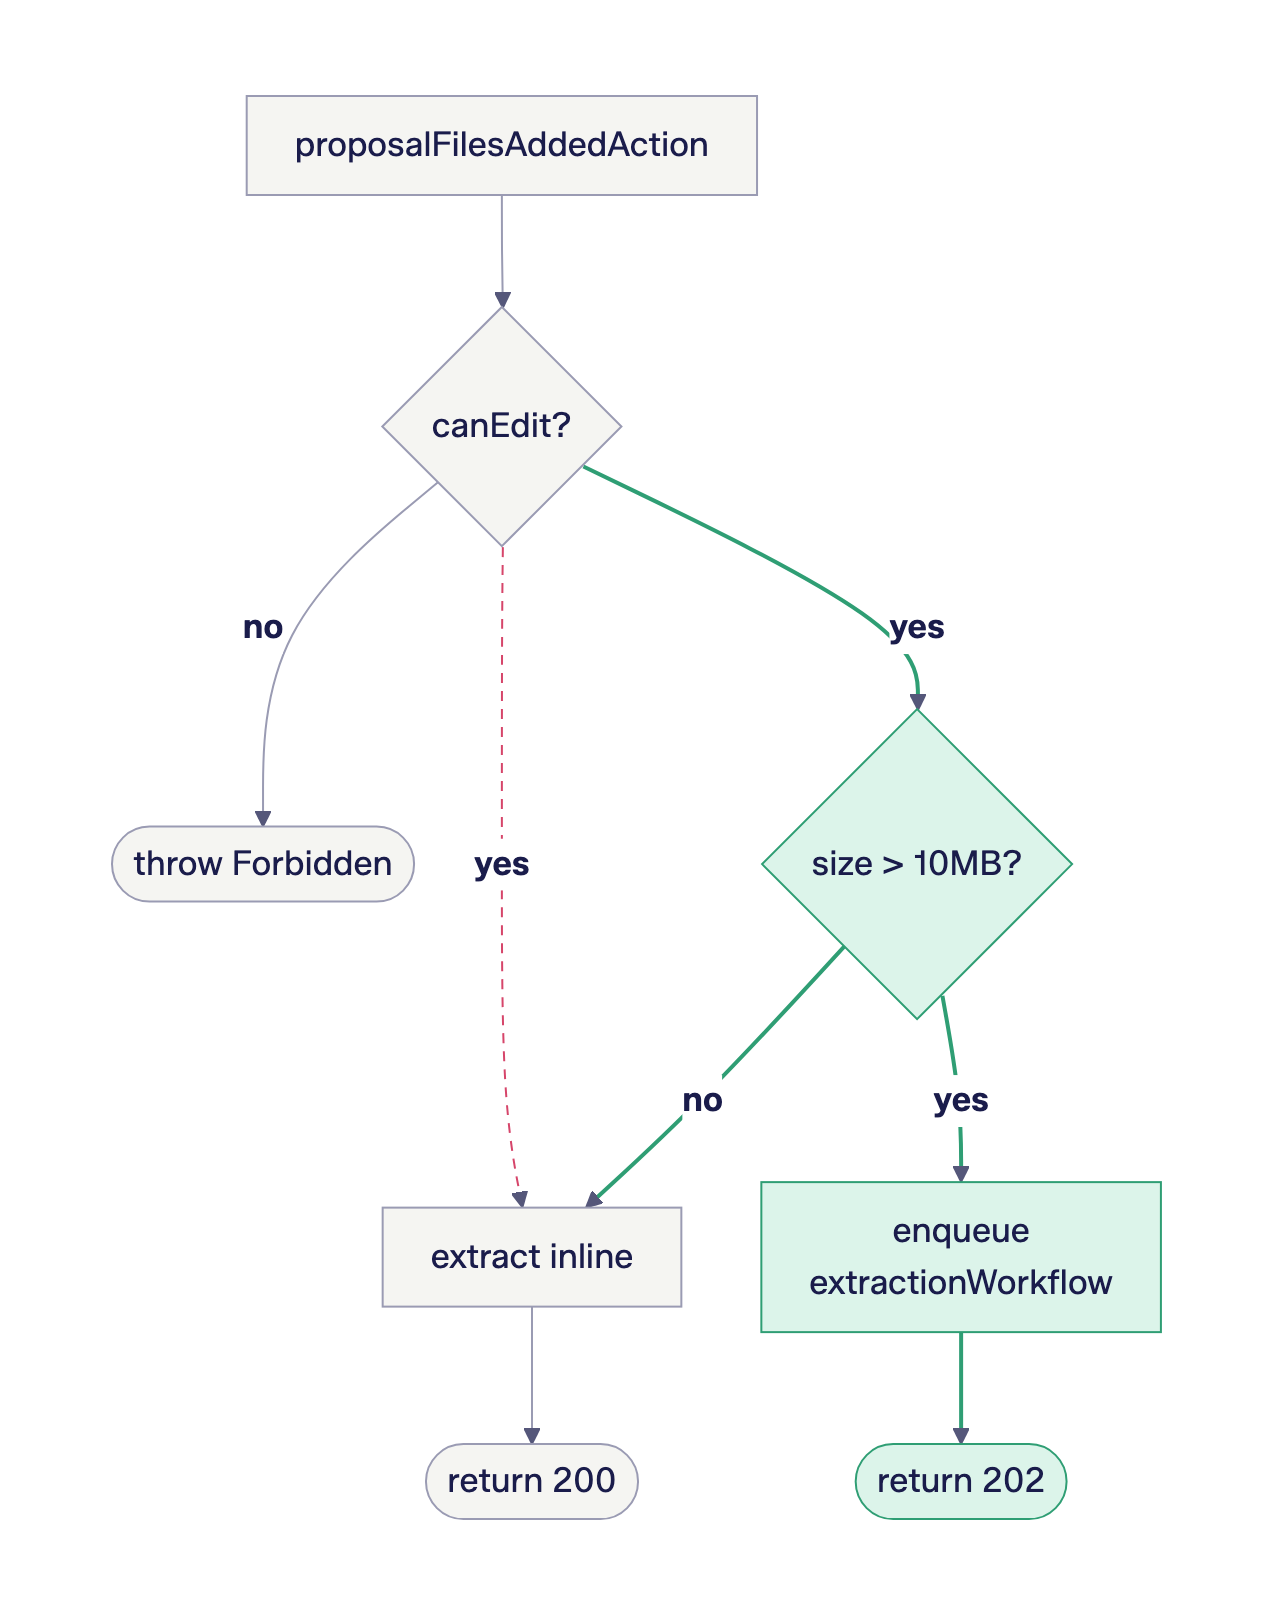
De beschrijving wordt na elke push bijgewerkt. In plaats van alles opnieuw te schrijven, past de action de bestaande beschrijving en diagrammen aan met alleen de nieuwe wijzigingen. Een reviewer die het al had gelezen hoeft dus alleen te kijken naar wat er anders is.
Deel twee: automatische review
De tweede action is de automatische review, die inline comments plaatst. De code wordt door zeven verschillende lenzen bekeken, elk vanuit een andere invalshoek: correctheid, security, gebruik van externe libraries, performance, tests, comments en simplicity. De laatste drie zijn er vooral om de code minder uitgebreid te maken. Elke pass vergelijkt de wijzigingen met de spec of het ticket, als die er zijn. Er wordt dus niet alleen op correctheid gecontroleerd, maar ook op intentie. Elke nieuwe push start een incrementele review van de changes.
De lenzen draaien parallel. Na elke lens volgt een nieuwe, aparte sessie die elke bevinding probeert te weerleggen door de code te lezen, en die alles weggooit wat niet kan worden bevestigd. Een laatste sessie voegt wat overblijft samen tot een GitHub-review, met één thread per bevinding en een adviserend oordeel:
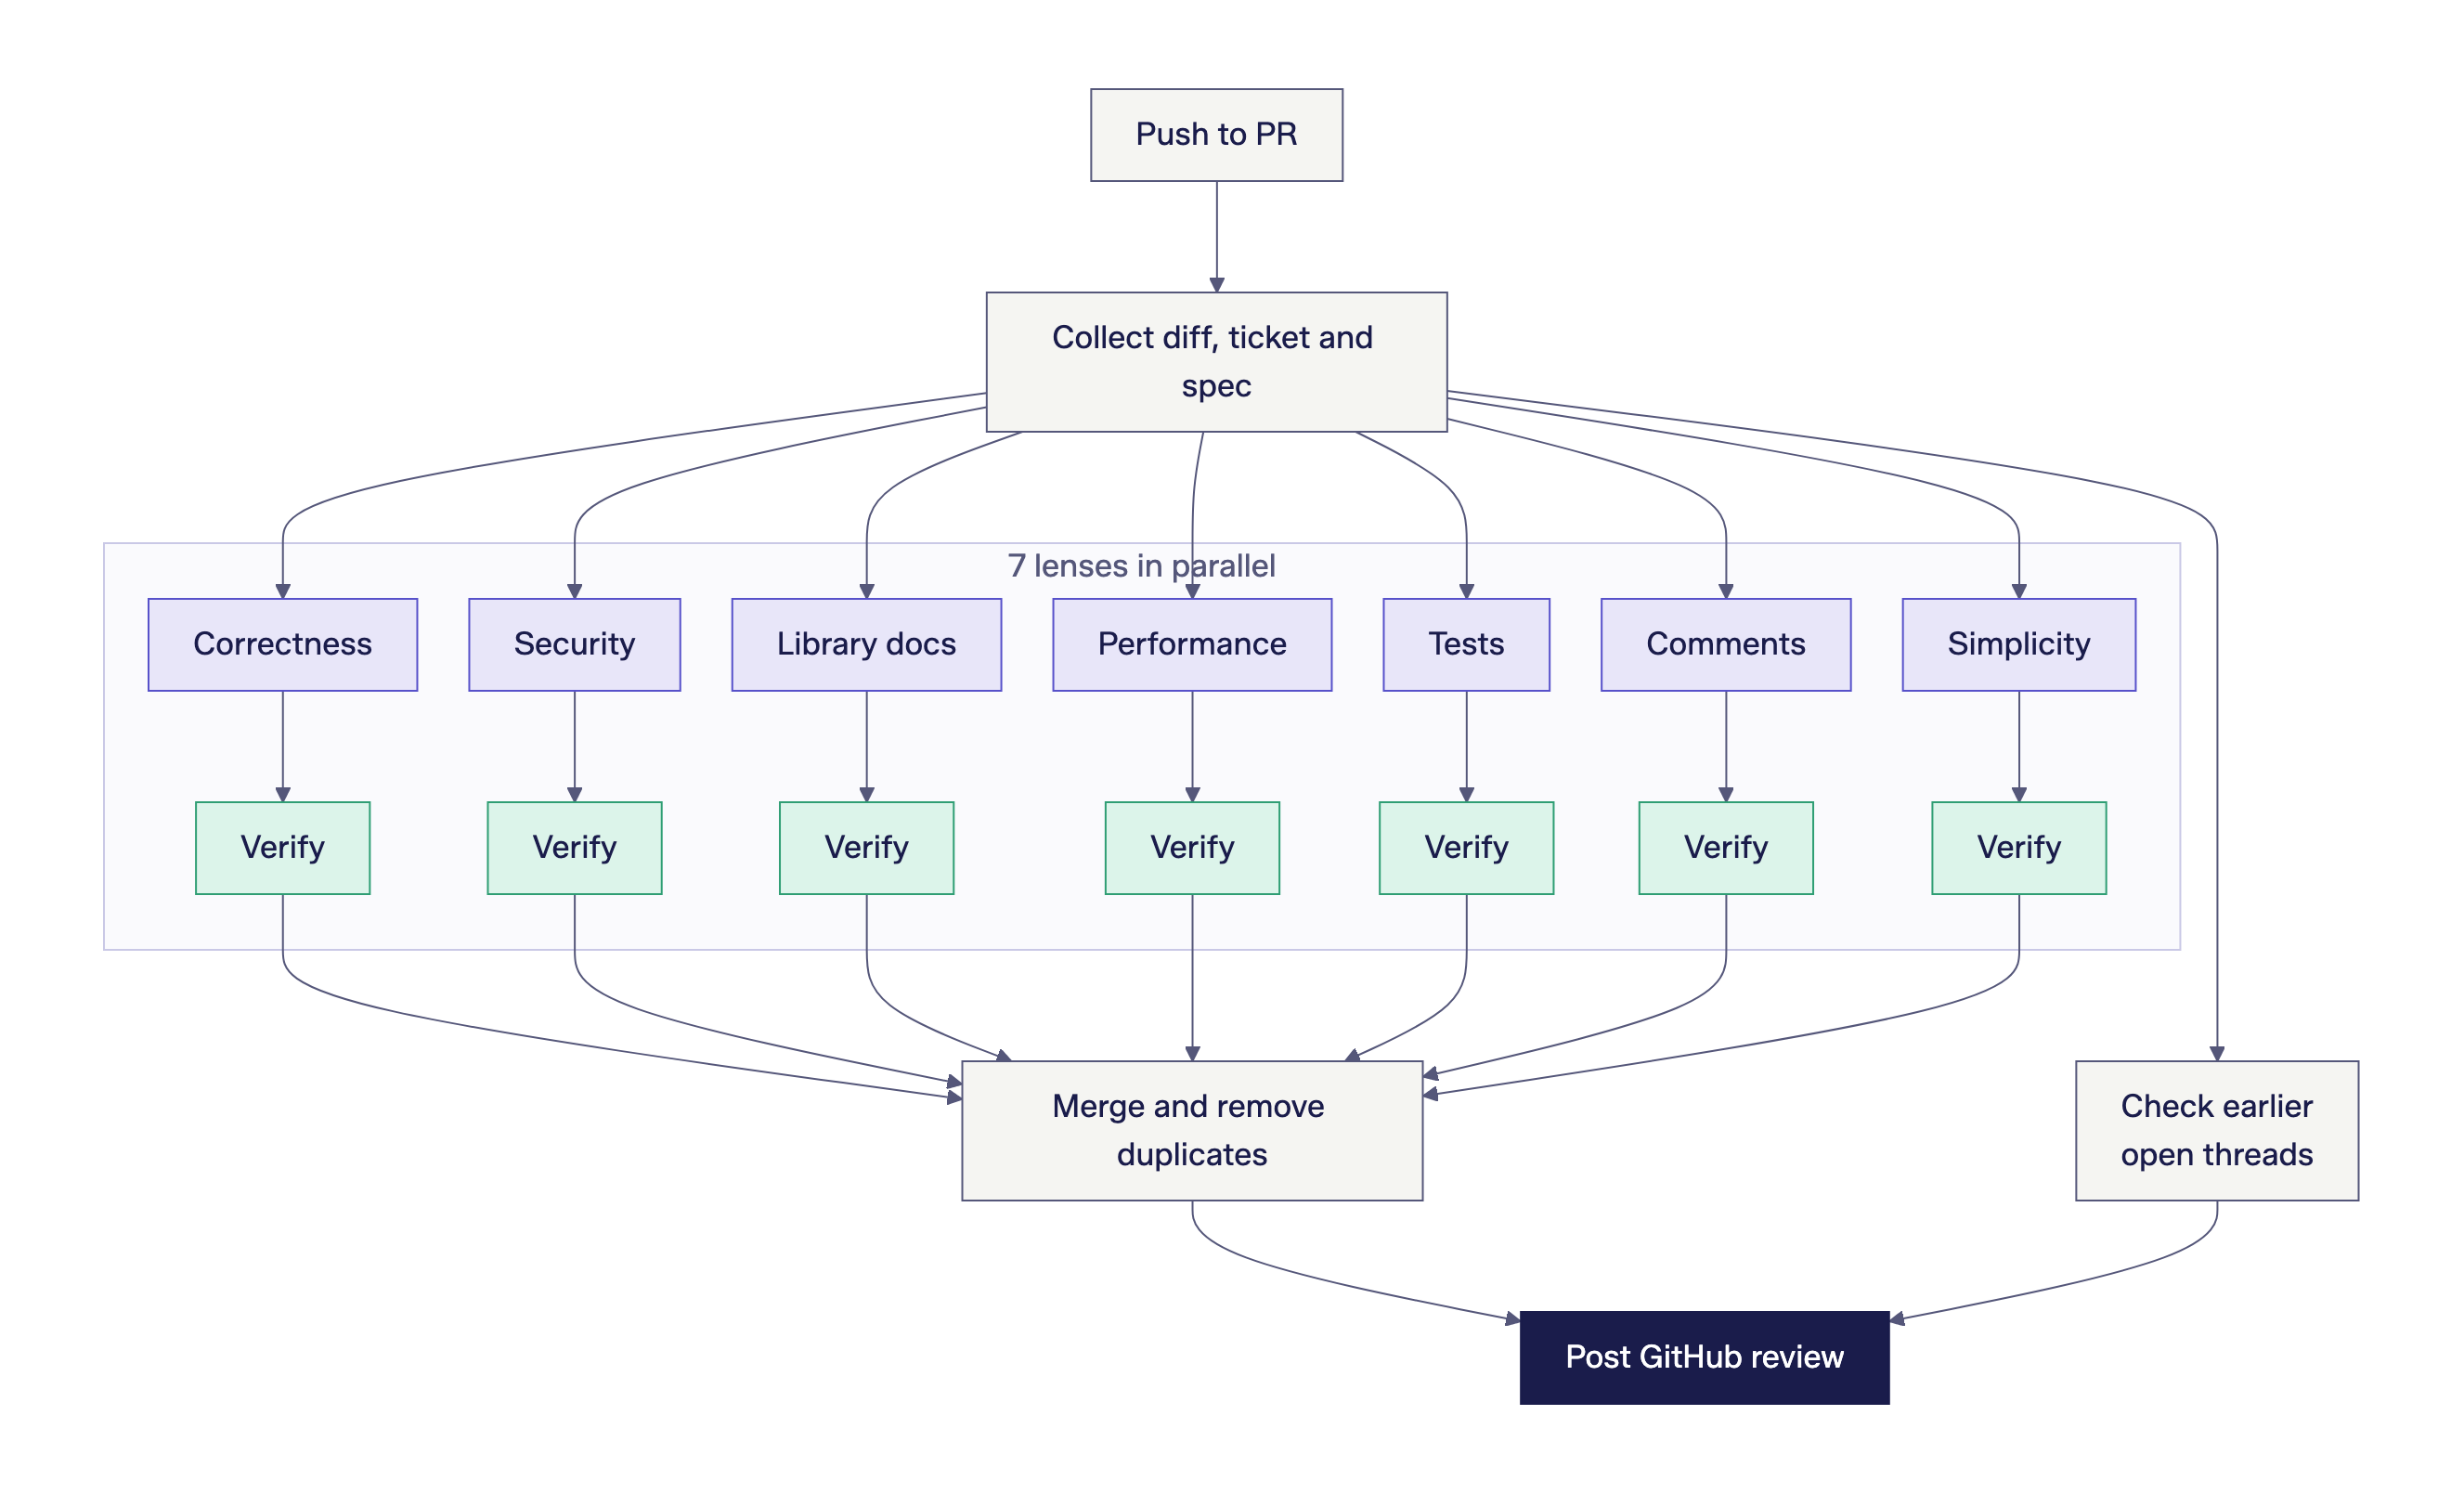
Bij elke push controleert de reviewer ook de threads die hij eerder heeft geopend. Is een probleem opgelost, dan reageert hij met de commit die het oploste en sluit hij de thread. Klopt een bevinding niet, dan kan iedereen met schrijfrechten reageren met een duim omlaag 👎 , en wordt die bevinding op die PR niet opnieuw gemeld.
Runner en harness: GitHub Actions en Pi
We wilden dat de reviewer draait waar onze pull requests al zijn, zonder een server om te hosten of te onderhouden. GitHub Actions doet precies dat. Een workflow start wanneer een PR wordt geopend, heropend, klaar voor review wordt gemarkeerd of een nieuwe push krijgt. Credentials staan als repository of organization secrets. Beide actions zijn verpakt als composite actions, dus elke repository in onze organisatie kan ze gebruiken door een job aan een workflow file toe te voegen. Elke run uploadt zijn werkbestanden en de logs van elke sessie, zodat we kunnen zien waarom een bevinding wel of niet is geplaatst.
De agent harness is Pi, die we installeren als Pi-Bolt. Pi is een kleine, open-source coding agent die zonder interactie vanuit een shellscript draait, en dat is alles wat we in CI nodig hebben. Elke lens, verificatiestap en samenvoegstap is een apart Pi-proces met eigen instructies, en een shellscript start ze en verzamelt de output. De instructies zelf zijn geschreven in Markdown in onze repository. Pi laat ons bovendien per run de provider, het model en het thinking level kiezen.
Waarom niet CodeRabbit of Greptile?
Platforms als Greptile en CodeRabbit bestaan. We hebben besloten ze niet te gebruiken, om drie redenen. Ten eerste voelen ze te log voor wat we in gedachten hadden. Ten tweede zijn beide duurder dan onze eigen opzet, terwijl de kwaliteit van hun reviews vergelijkbaar voelde met de onze, zo niet slechter. Ten derde wilden we volledige controle over de prompts voor de beschrijving en de review. In onze opzet is elke instructie een Markdown-bestand in onze eigen repository. Zijn we het oneens met een bevinding, dan passen we de prompt aan in een pull request, en die pull request wordt vervolgens door de reviewer zelf gereviewd.
Waarom het ons blij maakt
Het leek laaghangend fruit en vrij rechttoe rechtaan, maar voor ons voelt het bijna revolutionair. De reviewtijd is korter, omdat het pas zin heeft om een reviewer naar je PR te laten kijken als de automatische review klaar is, en tegen die tijd zijn de meeste comments al opgelost, zo niet allemaal. Reviewers hoeven de samenvatting en de visuals meestal maar een keer te bekijken om te bepalen of wat er is gebouwd overeenkomt met wat de bedoeling was. Het zwaartepunt van de review is verschoven naar design, weg van stijl en correctheid van de code. We hebben minder iteraties nodig om van een reviewverzoek naar een goedkeuring te komen. Een mooie bijvangst is minder context switching voor zowel schrijver als reviewer. En het belangrijkste: schrijver en reviewer hebben nu allebei een kader om de wijzigingen goed te begrijpen.