Beslismodellen krijgen veel aandacht. Modellen zoals Jev zetten een aantrekkelijk idee op de kaart: AI die de kleine beslissingen in een workflow zo snel neemt dat software bijna direct kan reageren als een bericht binnenkomt. Stel, een klant meldt een probleem in het Nederlands. Nog voordat iemand het bericht heeft geopend, is het al herkend als urgent, doorgestuurd naar het juiste team en klaargezet voor opvolging. Deze modellen zijn bovendien relatief licht en daardoor makkelijk zelf te hosten, en er zijn zelfs kant-en-klare scripts om ze zelf te fine-tunen. Snelle beslissingen, geoptimaliseerd voor je eigen workflows, zonder elk bericht naar een externe model-API te sturen: die combinatie wilden we graag uitproberen.
Tijdens de vierdaagse trip van Mozaik naar Nizza Monferrato in Piemonte hebben Ruben, Aziz, Dimitris en Eelco dat idee op de proef gesteld. We hebben een klein model gefine-tuned op Engelse en Nederlandse Slack-gesprekken, met Nederlandse werktaal als expliciet onderdeel van het experiment. Met beperkte tijd en middelen konden we het model inbouwen in ons bestaande werk en laten zien hoe verrassend succesvol en eenvoudig zo'n training kan zijn.
Van binnenkomend bericht naar werk
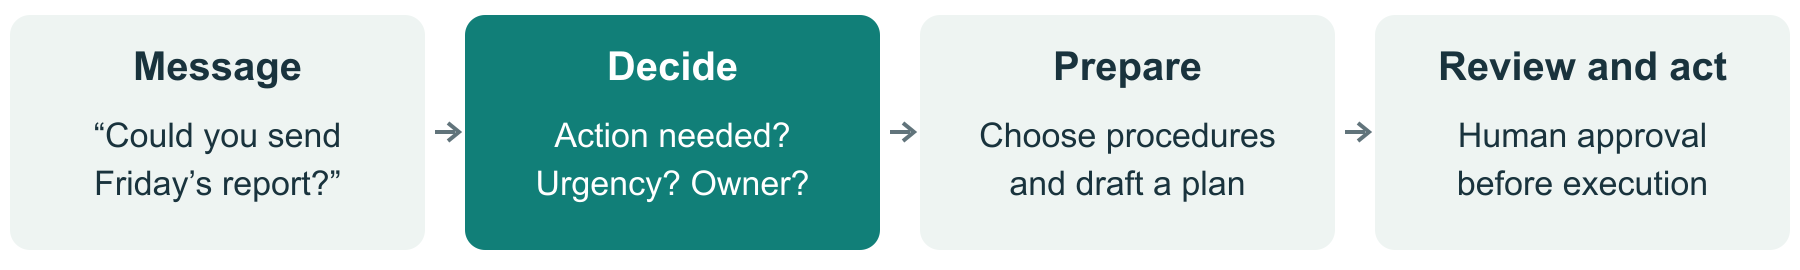
Bij Mozaik bouwen we aan CID, kort voor Consider-It-Done. Het koppelt AI aan de data en tools van een klant, zodat het verzoeken kan oppakken, de procedures van het team kan volgen en werk kan uitvoeren met menselijke goedkeuring. Het kan bijvoorbeeld informatie verzamelen voor een gevraagd rapport, dat rapport voorbereiden en om akkoord vragen voordat het wordt verstuurd.
De eerste stap in die workflow is bedrieglijk simpel: er komt een bericht binnen, en onze applicatie moet beslissen of dat bericht actie vraagt. "Kun je hier nog even naar kijken?" is een bekend verzoek om ergens naar te kijken. "Is inmiddels geregeld" zegt dat het al is afgehandeld. De taal herkennen is maar een deel van het werk; het model moet ook begrijpen wat die berichten betekenen voor het werk.
CID gebruikt op dit moment een groot taalmodel, een LLM, om deze berichten te interpreteren. We wilden zien of een klein beslismodel die eerste beoordeling kan overnemen, zodat het grotere model vrij is voor plannen en schrijven.
Waarom we een kleiner model wilden proberen
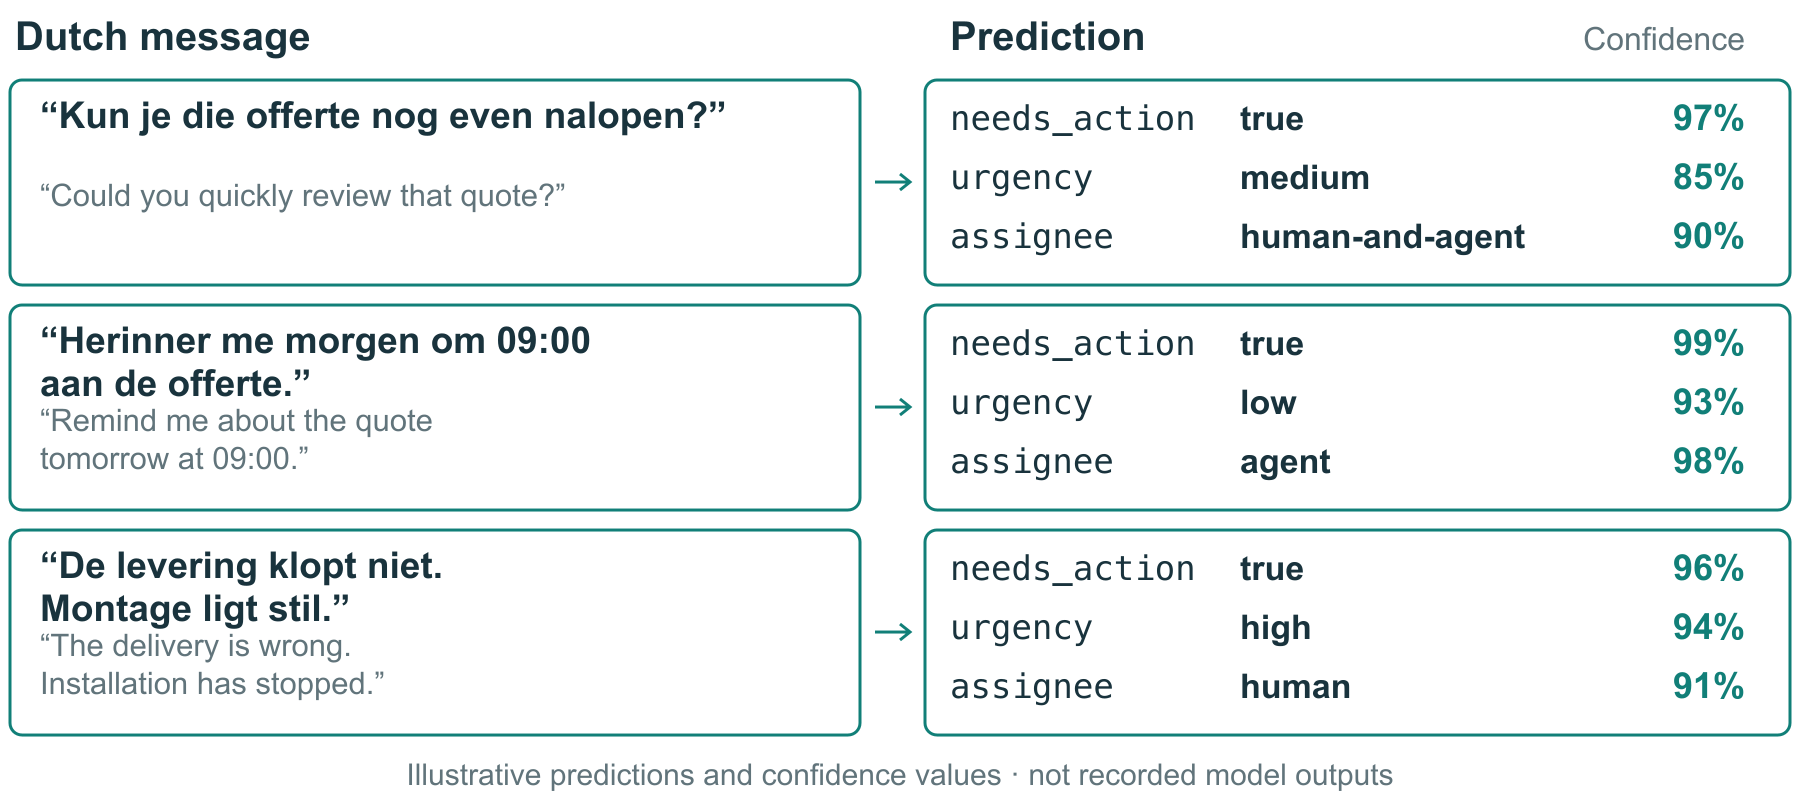
Een beslismodel kiest uit antwoorden die je zelf definieert, in plaats van vrije tekst te genereren: ja of nee op de vraag of actie nodig is, bijvoorbeeld, of laag, middel en hoog voor urgentie. Het geeft ook de waarschijnlijkheid van die antwoorden terug. De software kan die direct gebruiken om de volgende stap te kiezen.
De snelheid maakt dit spannend. Als de eerste beslissing heel weinig tijd kost, tot een paar milliseconden, kan het nuttige werk beginnen terwijl het bericht nog vers is. Voor een drukke inbox is het vooruitzicht om dat goedkoop en keer op keer te doen erg aantrekkelijk.
We kozen voor Kev, de open familie van beslismodellen van Jared Palmer, te beginnen met de kleinste versie, Kev-0.8B. Een model van dit formaat kan voorspellingen draaien op de meeste moderne laptops of op een relatief kleine virtuele machine, waarbij de snelheid afhangt van de hardware en de belasting. Daardoor is zelf hosten praktisch haalbaar: de berichten die het classificeert blijven op onze eigen hardware of in onze private cloud. Wij bepalen waar de beslissingen vallen en hoe het model aan onze systemen hangt.
Omdat Kev open is, kunnen we het ook fine-tunen op onze eigen behoeften: het extra trainen op onze taak om de voorspellingen te verbeteren. De trainingsdata van deze modellen is vooral Engels, terwijl onze klanten meestal in het Nederlands communiceren. Met fine-tunen konden we testen of we dat gat kunnen dichten, en tegelijk het model afstemmen op onze specifieke taak en ons jargon.
Het model aanpassen aan Nederlandse werktaal
De eerste stap van fine-tunen is trainingsdata verzamelen. Om goed te presteren op onze taak moest het trainingsmateriaal lijken op onze echte toepassingen, dus op echte gesprekken op de werkvloer. Dat betekent halve zinnen, verwijzingen naar eerdere berichten, sarcasme en verzoeken die iemand al had afgehandeld. Een verzameling keurig beleefde instructies zou geen echte test zijn.
We genereerden bijna 6.000 fictieve gesprekken, ongeveer de helft in het Nederlands en de helft in het Engels, in 32 verschillende werksituaties. De Nederlandse gesprekken zijn direct in het Nederlands geschreven, inclusief informele formuleringen en af en toe een typfout. Na een paar rondes van voorbeelden geven en het model bijsturen zetten we twee DeepSeek V4.1 Flash-agents, via OpenRouter, aan het werk: de een schreef de gesprekken, de ander labelde wat de voorspelde uitkomst zou moeten zijn op 11 verschillende beslissingen, waaronder "Vraagt dit bericht actie?", "Hoe urgent is dit bericht?" en "Wie moet dit bericht oppakken?". Die gesprekken en labels werden de voorbeelden waarmee we in de volgende stap het kleine beslismodel onze taak leerden.
Het trainingsrecept van Kev nam een groot deel van de machinerie voor zijn rekening. We hebben het model gefine-tuned op onze eigen NVIDIA DGX Spark, met een trainingsrun van ongeveer vijf uur. Het genereren en labelen van de voorbeelden via OpenRouter kostte 10,45 dollar; de training zelf draaide op onze eigen hardware.
Het verbaasde ons hoe eenvoudig dat deel was. Fine-tunen klinkt als een fors onderzoeksproject. Hier hadden we na vijf uur trainen een model dat op onze taak was aangepast, met tools die we konden volgen en hergebruiken. Goede voorbeelden definiëren en de antwoorden controleren vroeg nog steeds aandacht, maar de training zelf was verrassend toegankelijk.
De resultaten en een naam
Na wat geplaag over hoe het moest heten, werd ons gefine-tunede model "Joost". De uitdrukking "Joost mag het weten" betekent zoiets als "Wie zal het zeggen?". Een optimistische keuze voor iets dat we juist trainden om antwoorden te geven. Er volgden meerdere rondes aan logo- en mascotte-ontwerpen.
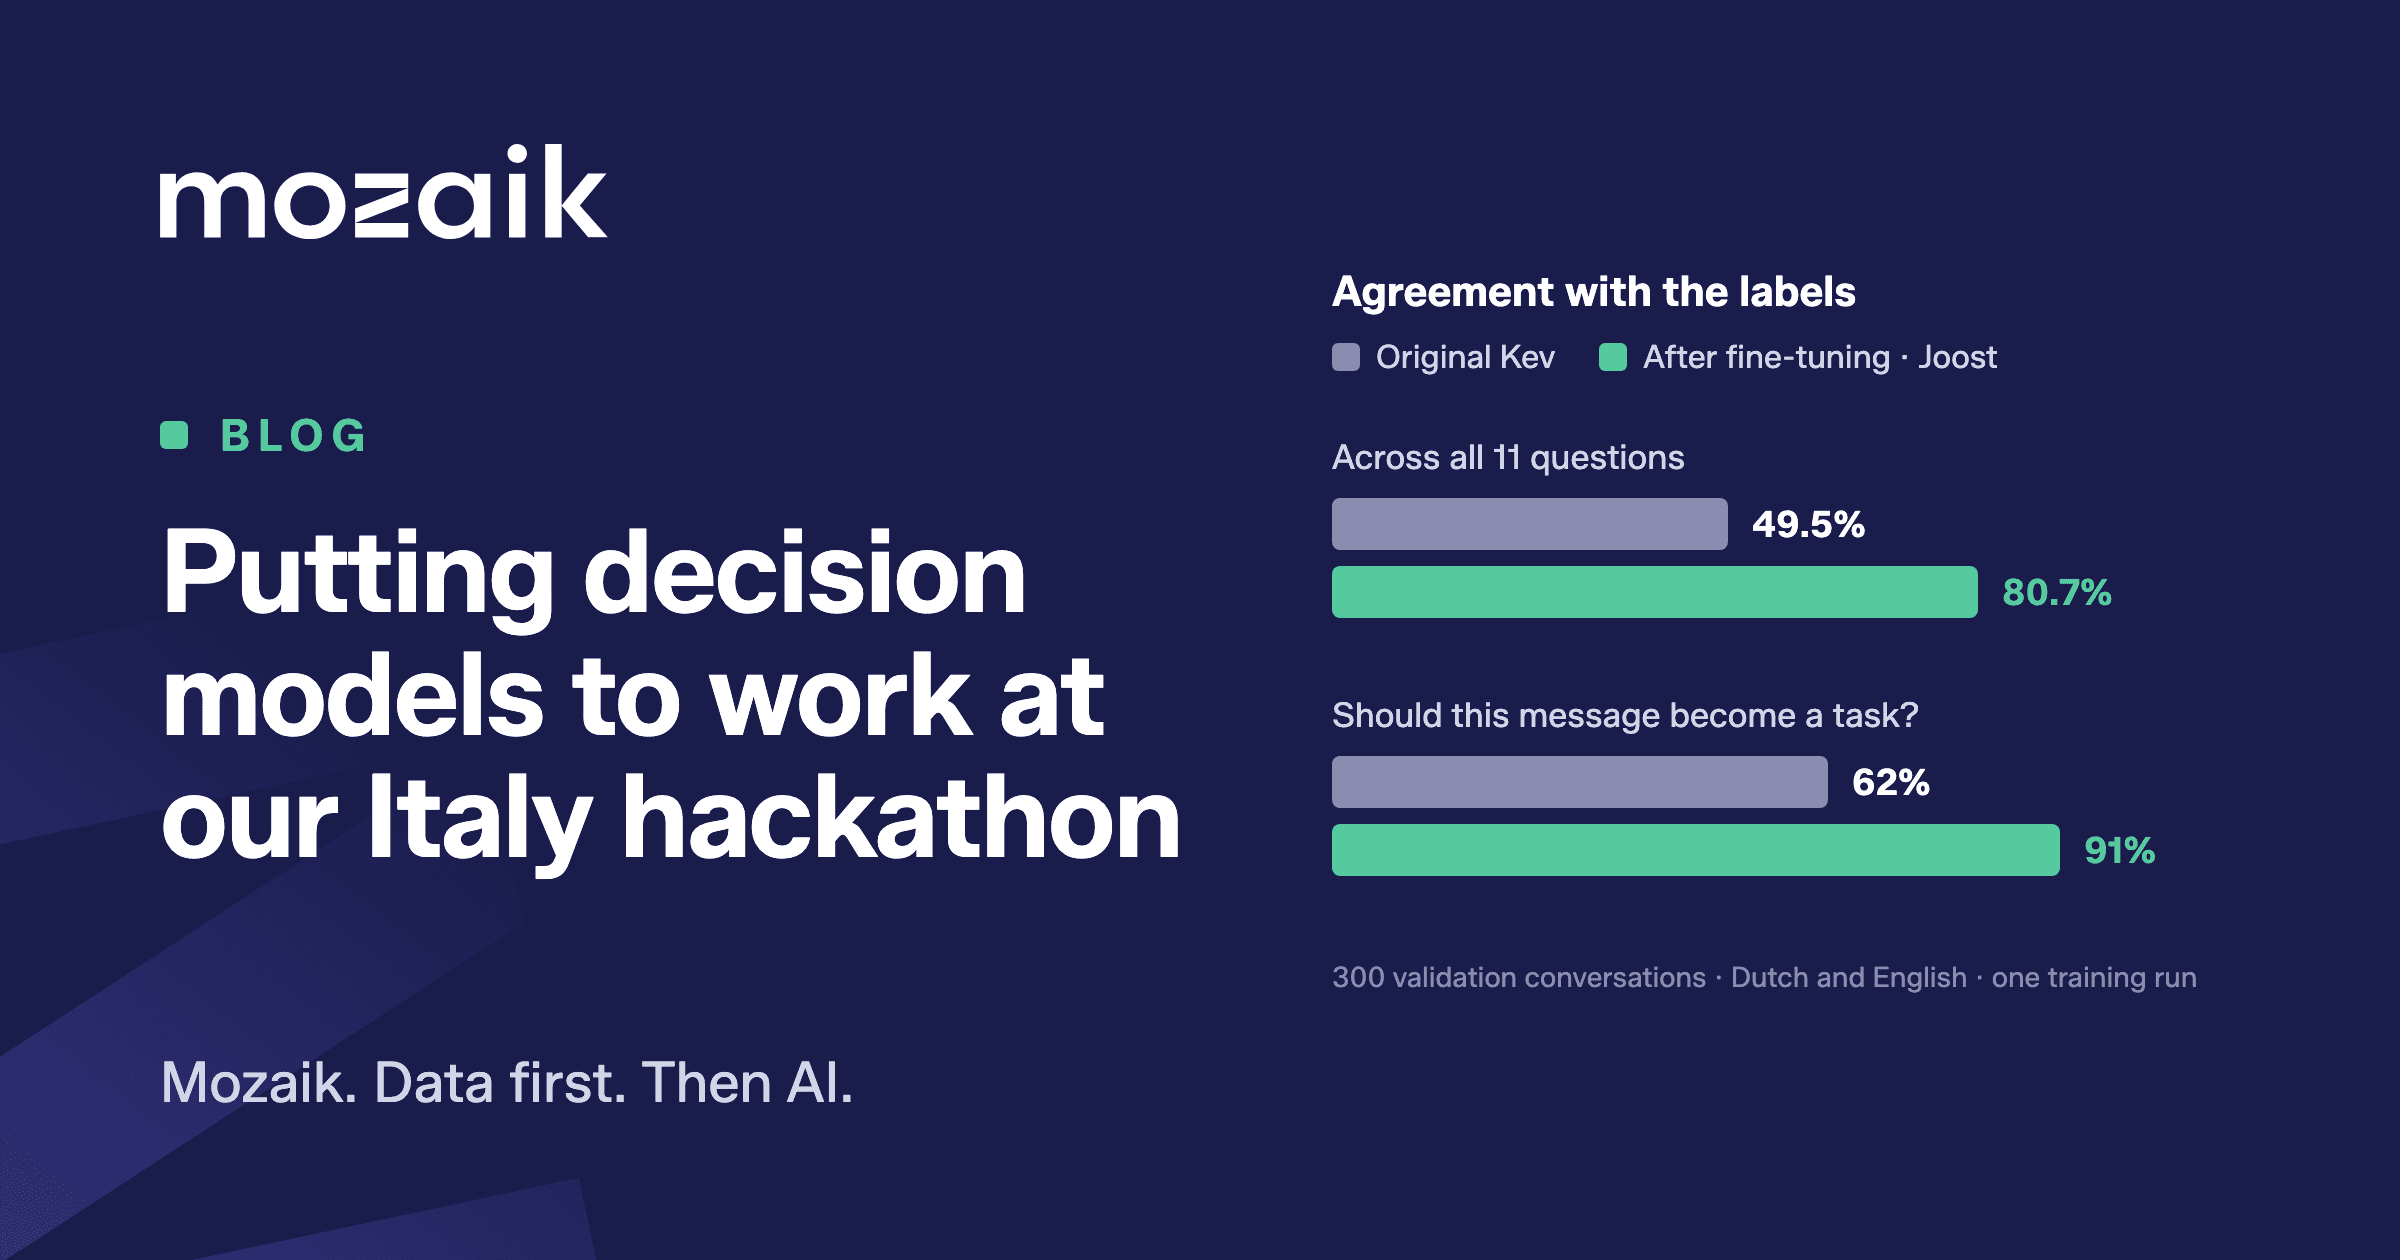
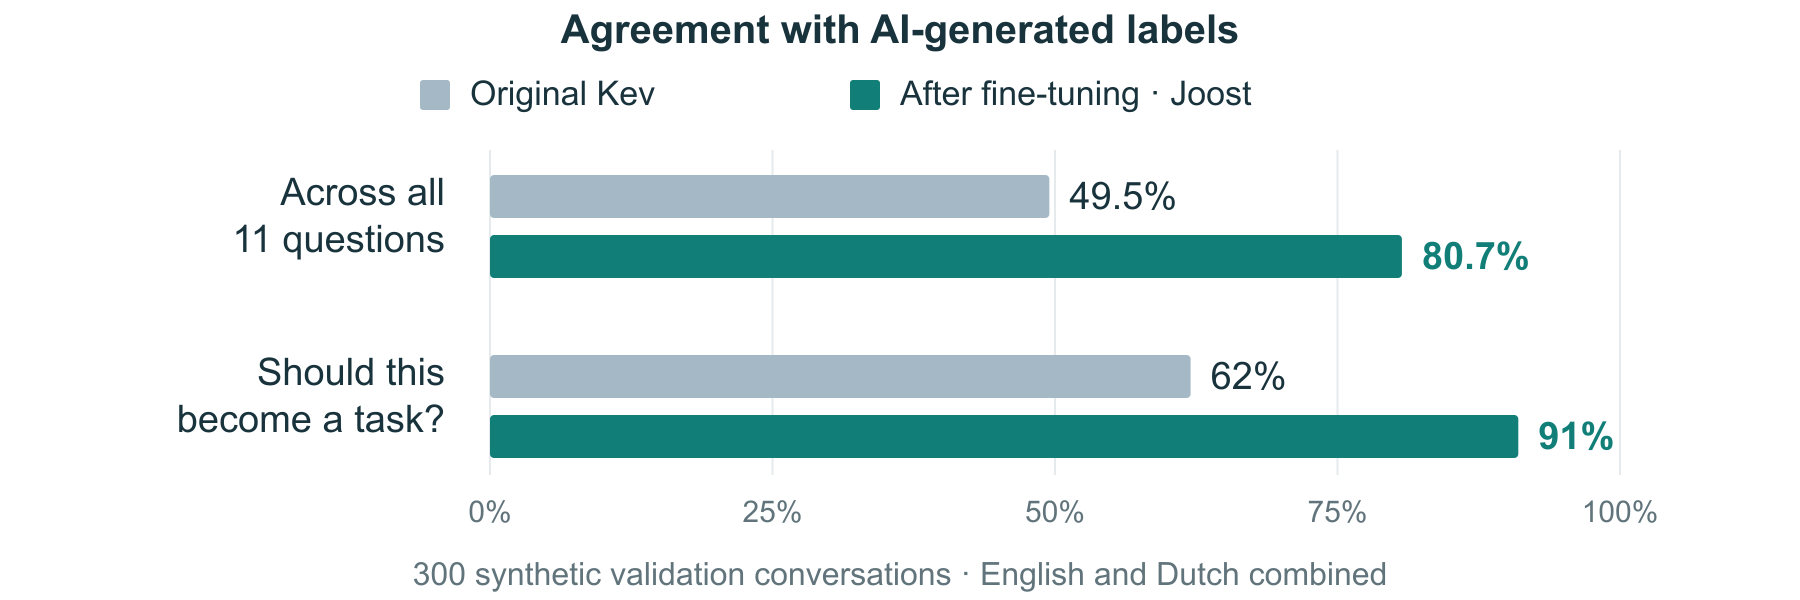
Trainen op onze Engelse en Nederlandse voorbeelden maakte een groot verschil. Over onze elf vragen steeg de overeenstemming met de AI-gegenereerde labels van ongeveer 50% naar 81%, met evenveel winst in het Nederlands als in het Engels. Op de centrale vraag, of een bericht een taak moet worden, ging het van 62% naar 91%. Die sprong zien na één enkele trainingsrun was het hoogtepunt van het experiment.
Tijdens de demo op de hackathon konden we laten zien wat het betekent om dit model echt in te bouwen in een workflow die we kennen: live een bericht in Slack plaatsen en binnen een seconde een vervolgtaak zien verschijnen voelt als magie. De beslissingen kwamen bij inspectie ook overeen met onze eigen verwachtingen, en in meerdere gevallen waarin ons gefine-tunede model en de LLM van mening verschilden, waren wij het met de eerste eens. Nu de hackathon voorbij is, is de volgende stap om de impact op onze live applicaties te valideren, en we hebben er vertrouwen in dat deze resultaten overeind blijven.
Waar beslismodellen kunnen helpen
Denk aan de berichten of documenten die je team elke dag doorneemt. Leest iemand ze steeds opnieuw, alleen om te bepalen waar ze heen moeten, of ze aandacht nodig hebben, of wat er vervolgens moet gebeuren? Dan zit je op de goede plek. Een support-inbox zou berichten bij binnenkomst naar facturatie of technische ondersteuning kunnen sturen. Een operations-team zou mogelijke blokkades aangewezen kunnen krijgen tussen de routinematige updates. Een documentworkflow zou onvolledige aanvragen kunnen markeren voordat iemand er tijd in steekt.
Wil je het zelf proberen als bouwer, begin dan met één beslissing en echte voorbeelden in de talen die je team gebruikt. De quick start en het trainingsrecept van Kev zijn goede startpunten. Probeer het bestaande model, bekijk waar het fouten maakt en fine-tune waar jouw Nederlandse formuleringen, terminologie of regels extra aandacht vragen. Controleer de prestaties op aparte voorbeelden per taal. Is berichten op je eigen infrastructuur houden onderdeel van het doel, test die opzet dan ook. Zelf hosten is een voordeel van een open model zoals Kev; je hebt nog steeds geschikte hardware nodig en iemand die het beheert. Meet de complete workflow, inclusief latere stappen die externe diensten aanroepen.
We overwegen beslismodellen serieus voor klantprojecten. We kwamen met veel meer enthousiasme uit Italië terug om ermee aan de slag te gaan: met maar drie dagen hackathontijd en een bescheiden budget van zo'n 10 dollar konden we de potentie van deze modellen aantonen op een flow die aan de basis ligt van veel toepassingen. Er is ook nog veel ruimte voor verbetering: we kunnen nieuwe fine-tuningdatasets samenstellen om de prestaties verder op te voeren, misschien zelfs voorbij de beste LLM's, grotere modelformaten testen en andere stappen in onze workflows onderzoeken waar beslismodellen kunnen helpen.
Herken je hier een van je eigen problemen in, dan horen we het graag. Neem een paar voorbeelden mee in de taal die je team gebruikt, plus je eisen aan waar de data moet blijven. We helpen je testen of een beslismodel past en zetten het aan het werk in jouw omgeving.